고정 헤더 영역

상세 컨텐츠
본문
반응형
AI가 지어낸 답에 속지 않으려면?
누구나 바로 쓰는 AI 할루시네이션 예방법 5가지
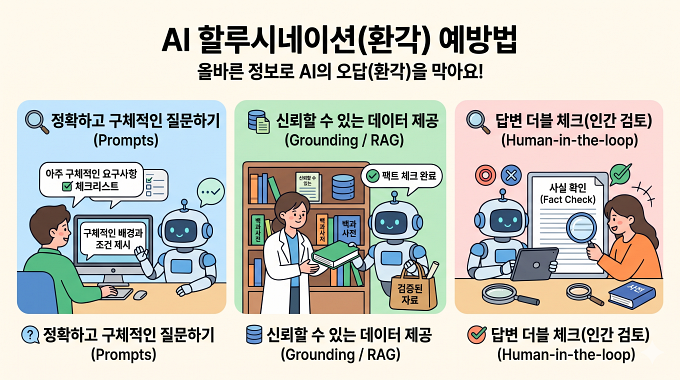
AI 할루시네이션(AI 환각)은 AI가 사실이 아닌 내용을 사실처럼 말하는 현상이다. 완전히 없앨 수는 없지만, 쓰는 사람의 습관으로 크게 줄일 수 있다. 연구 결과와 공식 지침을 바탕으로 누구나 바로 따라 할 수 있는 예방법 다섯 가지를 정리했다.
왜 ‘예방’이 필요할까?
AI는 모르는 것도 아는 척 답한다. 2024년 국제 의학 학술지(JMIR)에 실린 프랑스 연구진의 실험이 이를 잘 보여 준다. 연구진이 챗GPT와 구글 바드에게 논문을 찾게 했더니, GPT-4가 내놓은 논문의 28.6%, GPT-3.5는 39.6%, 바드는 무려 91.4%가 제목·저자·연도가 틀린 가짜였다.
AI 회사들도 할루시네이션을 줄이고 있지만 아직 0으로 만들지는 못했다. 그래서 쓰는 사람이 미리 막는 습관이 필요하다.
예방법 ① “모르면 모른다고 해도 돼”라고 말해 주기
AI는 기본적으로 어떻게든 답하려 한다. 그러니 질문할 때 빠져나갈 길을 열어 주자. Claude를 만든 앤트로픽은 공식 안내 문서에서, AI가 “모른다”고 말해도 된다고 분명히 허락하는 것만으로 거짓 정보를 크게 줄일 수 있다고 설명한다.
예) “확실하지 않으면 추측하지 말고 ‘모르겠다’고 답해 줘.”
반응형
예방법 ② 자료를 주고, 그 안에서만 답하게 하기
AI의 기억에만 기대면 틀릴 가능성이 커진다. 보고서, 규정, 기사처럼 근거가 되는 자료를 직접 붙여 넣고 “이 자료에 있는 내용으로만 답해 달라”고 요청하자. 앤트로픽은 긴 문서를 다룰 때 관련 문장을 원문 그대로 먼저 뽑게 한 뒤 답하게 하면 할루시네이션이 줄어든다고 안내한다. 인용문이 있으니 사람이 확인하기도 쉽다.
다만 자료를 줘도 오류가 사라지지는 않는다. 스탠퍼드대 연구진이 판례 데이터베이스와 연결된 전문 법률 AI를 시험해 보니, 일반 챗봇보다는 나았지만 여전히 17~33%의 답에서 할루시네이션이 나왔다.
예방법 ③ AI에게 스스로 검증하게 하기
메타(Meta) AI 연구진은 ‘검증의 사슬(Chain-of-Verification)’이라는 방법을 내놓았다. AI가 먼저 답을 쓰고, 그 답을 점검할 질문을 스스로 만든 뒤, 질문마다 따로 답해 보고, 마지막에 처음 답을 고치는 방식이다. 인물 소개 글을 쓰는 실험에서 사실 정확도 점수가 55.9점에서 71.4점으로 올랐다.
예) “방금 답에서 사실 주장만 뽑아 하나씩 다시 확인하고, 틀린 부분은 고쳐 줘.”
예방법 ④ 출처는 반드시 직접 열어 보기
가장 확실한 예방법은 사람이 원문을 확인하는 것이다. 이때 AI에게 “이거 진짜야?”라고 다시 묻는 것은 검증이 아니다. 2023년 미국에서 가짜 판례를 법원에 냈다가 벌금을 문 변호사도 챗GPT에게 진짜냐고 물었고, “진짜”라는 답을 그대로 믿었다.
법령은 국가법령정보센터, 통계는 국가통계포털(KOSIS), 논문은 학술 데이터베이스에서 직접 찾아 대조하자. 행정안전부도 공무원용 챗GPT 안내서에서 AI의 답변은 반드시 사실 여부를 검증하고 확인하라고 당부했다.
예방법 ⑤ 중요한 일일수록 사람이 마지막에 확인하기
모든 답을 똑같이 검증할 필요는 없다. 아이디어를 모으거나 문장을 다듬는 일은 가볍게 써도 된다. 그러나 보고서의 숫자, 계약서, 법률·의료 정보처럼 틀리면 피해가 큰 일은 반드시 사람이 최종 검토해야 한다. 앤트로픽 역시 위의 방법들이 할루시네이션을 크게 줄여 주지만 완전히 없애지는 못한다며, 중요한 결정일수록 꼭 검증하라고 강조한다.
할루시네이션 예방은 어려운 기술이 아니다. 모르면 모른다고 하게 하고, 자료를 주고, 스스로 점검하게 하고, 원문을 확인하고, 마지막에 사람이 본다. 이 다섯 가지 습관만 지켜도 AI는 훨씬 믿을 만한 도우미가 된다.
반응형
'About AI' 카테고리의 다른 글
| AI 할루시네이션, 무엇이 문제일까? (0) | 2026.11.05 |
|---|---|
| AI가 답을 대신 내주는 시대, 왜 '판단력'이 마지막 경쟁력인가 (0) | 2026.08.18 |
| 인공지능이 대신할 수 없는 인간의 강점 (0) | 2026.08.13 |
| AI가 인간의 창의력을 대체하지 못하는 이유 (1) | 2026.08.11 |
| 온디바이스 AI의 빛과 그림자 (0) | 2026.07.23 |