고정 헤더 영역

상세 컨텐츠
본문
반응형
뉴로모픽 칩은 왜 전기를 100배 덜 먹을까?
뇌를 닮은 반도체의 비밀
사람의 뇌는 전구 하나 수준인 약 20와트로 보고, 듣고, 기억하고, 판단한다. 반면 오늘날의 인공지능은 한 번 학습하는 데 소도시 하나가 쓰는 전기를 삼키고, 데이터센터는 전력망의 새로운 골칫거리가 되었다. 인텔 뉴로모픽 연구소장 마이크 데이비스가 “AI 모델의 연산 비용이 지속 불가능한 속도로 오르고 있다”고 경고한 것도 이 때문이다. 그렇다면 질문은 하나다. 뇌처럼 계산하는 칩을 만들면 전기를 정말 덜 쓸 수 있을까? 뉴로모픽 컴퓨팅은 이 질문에 세 가지 측면에서 구체적인 숫자로 답하고 있다.
첫째, 데이터를 옮기지 않으면 전기가 줄어든다
우리가 쓰는 컴퓨터는 70년 넘게 폰노이만 구조를 따른다. 계산하는 곳(프로세서)과 기억하는 곳(메모리)이 떨어져 있어서, 계산할 때마다 데이터를 왕복시켜야 한다. 문제는 이 왕복이 계산보다 훨씬 비싸다는 점이다. 스탠퍼드대 마크 호로위츠 교수가 2014년 국제고체회로학회(ISSCC)에서 발표한 분석에 따르면, 외부 메모리(DRAM)에서 32비트 데이터를 한 번 읽어오는 데 드는 에너지는 같은 크기의 덧셈 한 번보다 수백 배 크다. 다시 말해 AI 칩이 먹는 전기의 상당 부분은 ‘생각’이 아니라 ‘심부름’에 쓰인다.
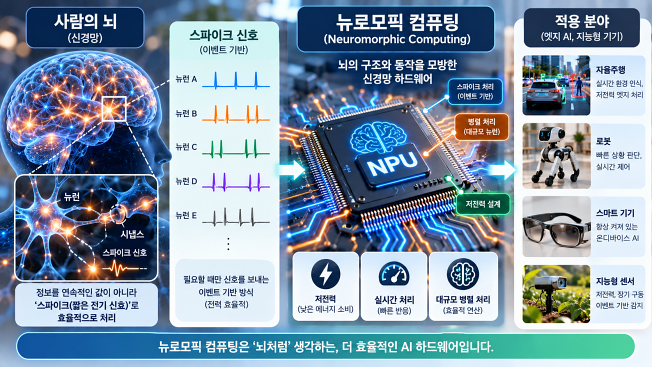
뇌는 이 심부름이 없다. 뉴런 하나하나가 기억과 계산을 함께 한다. IBM이 2023년 국제학술지 「사이언스」에 발표한 NorthPole 칩은 이 원리를 실리콘으로 옮겼다. 모든 메모리를 칩 안 연산 코어 바로 옆에 두어 외부 메모리 접근을 없앤 결과, 같은 12나노 공정의 엔비디아 V100 GPU보다 이미지 인식(ResNet-50)에서 에너지 효율이 약 25배 높았고, 훨씬 미세한 4나노 공정의 H100과 비교해도 약 5배 효율적이었다. 공정의 열세를 구조의 힘으로 뒤집은 셈이다.
반응형
둘째, 일이 없으면 쉰다: 스파이크와 희소성
기존 신경망은 입력이 바뀌었든 아니든 매 순간 모든 뉴런이 곱셈과 덧셈을 반복한다. 반면 뉴로모픽 칩이 돌리는 스파이킹 신경망(SNN)은 생물의 뉴런처럼 신호가 일정 문턱을 넘을 때만 ‘스파이크’라는 짧은 신호를 보낸다. 신호가 없으면 계산도 없고, 계산이 없으면 전력도 거의 들지 않는다. 인텔이 2024년 공개한 세계 최대 뉴로모픽 시스템 할라 포인트(Hala Point)는 로이히 2 칩 1,152개, 인공 뉴런 약 11억 5천만 개로 구성되며, 연결의 90%가 비어 있는 희소 신경망에서 와트당 15조 회(15 TOPS/W) 이상의 연산을 해낸다. 인텔은 로이히 계열 시스템이 일부 추론·최적화 문제에서 기존 CPU·GPU보다 최대 100배 적은 에너지로 50배 빠르게 동작한다고 밝혔다. 다만 이 수치는 특정 작업과 조건에서 측정된 회사 발표이므로, 모든 AI 작업에 그대로 적용된다고 보아서는 안 된다.
셋째, 눈부터 바꾼다: 이벤트 카메라
전력 절감은 칩 안에서 끝나지 않는다. 일반 카메라는 초당 30장씩 화면 전체를 찍어 보내므로, 아무 일도 없는 텅 빈 복도도 매 프레임 똑같이 처리해야 한다. 뉴로모픽 시각 센서, 즉 이벤트 카메라는 다르다. 국제학술지 IEEE TPAMI에 실린 갈레고(Gallego) 연구진의 종합 리뷰에 따르면, 이벤트 카메라는 각 화소가 밝기 변화를 독립적으로 감지해 변화가 생긴 위치와 시각만 기록한다. 마이크로초 단위의 시간 해상도, 일반 카메라(약 60dB)를 크게 넘는 140dB의 명암 범위, 그리고 낮은 소비 전력이 특징이다. 움직임이 없으면 데이터도 나오지 않으니, 센서·전송·연산 전 과정에서 전기가 절약된다.
같은 장소, 다른 시간대의 사람을 어떻게 알아볼까
여기서 흥미로운 응용이 등장한다. 오전 9시 지하철 출구 CCTV에 찍힌 사람이 오후 7시 같은 출구에 다시 나타났을 때, 기계는 그가 같은 사람임을 어떻게 알 수 있을까? 이 문제를 ‘사람 재식별(Person Re-identification, Re-ID)’이라 한다. 핵심은 얼굴 대신 한 사람을 대표하는 특징을 숫자 묶음(특징 벡터)으로 바꿔 저장해 두었다가, 새로 등장한 사람의 벡터와 거리를 비교하는 것이다. 거리가 가까울수록 같은 사람일 가능성이 높다.
뉴로모픽 방식은 이 과정을 세 단계로 효율화한다. 먼저, 고정된 카메라 앞에서 벽과 바닥은 변하지 않으므로 이벤트가 생기지 않는다. 화면에서 신호를 만드는 것은 오직 움직이는 사람뿐이라, 별도의 배경 제거 연산 없이 사람만 자연스럽게 떠오른다. 다음으로, 스파이킹 신경망은 스파이크가 언제 발생했는지라는 시간 정보를 그대로 다루기 때문에 걸음걸이의 리듬, 팔을 흔드는 방식, 체형의 움직임 같은 동적 특징을 잘 잡아낸다. 옷이나 조명은 시간대마다 달라져도 걷는 습관은 쉽게 바뀌지 않는다. 마지막으로, 이벤트 카메라의 넓은 명암 범위 덕분에 한낮의 역광과 밤의 어둠이라는 서로 다른 조건에서도 비교적 안정적인 신호를 얻는다.
실제 연구도 이를 뒷받침한다. 로체스터대 연구진은 2023년 컴퓨터비전 최고 학회인 CVPR에서, 일반 영상으로는 외모 특징을, 이벤트 신호와 스파이킹 신경망으로는 보행자의 움직임 단서를 추출해 결합하는 방법을 발표했고, 여러 벤치마크에서 기존 방법을 능가했다. 2025년 발표된 S3CE-Net은 아예 스파이킹 신경망만으로 긴 시간의 이벤트 영상을 처리하는 재식별 모델로, 열악한 조명에 강하고 배경 간섭을 줄이며 얼굴 정보를 보호한다는 장점을 내세운다. 얼굴을 찍지 않고도 사람을 구분할 수 있다는 점은 사생활 보호에 유리하지만, 걸음걸이 역시 개인을 식별하는 생체정보라는 점에서 사회적 합의가 함께 필요하다.
아직 넘어야 할 산
뉴로모픽 컴퓨팅이 곧바로 GPU를 대체하리라 보기는 어렵다. 앞의 효율 수치들은 희소성이 높거나 정밀도를 낮춘 특정 조건에서 나온 결과이고, 스파이킹 신경망은 학습 방법과 개발 도구가 아직 성숙하지 않았다. 그러나 방향은 분명하다. 반도체 미세화의 이득이 점점 줄어드는 지금, 전기를 아끼는 가장 확실한 길은 더 작은 트랜지스터가 아니라 더 영리한 구조다. 쓸데없이 옮기지 않고, 일이 없으면 쉬고, 변화만 본다. 20와트로 세상을 이해하는 뇌가 이미 증명한 원리를, 이제 반도체가 배우고 있다.
반응형
'피지컬AI' 카테고리의 다른 글
| AI는 정말 ‘전기 먹는 하마’일까? (0) | 2026.10.06 |
|---|---|
| 정량적 값과 정성적 값의 차이, 숫자가 놓치는 것과 느낌이 틀리는 것 (0) | 2026.09.30 |
| 피지컬 AI가 정량적 값에는 강하고 정성적 값에는 약한 진짜 이유 (0) | 2026.09.28 |
| 디지털 트윈이 만든 데이터와 진짜 세계가 어긋나는 이유 (0) | 2026.09.21 |
| AI도 쌍둥이 앞에서는 헷갈릴까? (0) | 2026.09.15 |


