AI는 정말 ‘전기 먹는 하마’일까?
AI는 정말 ‘전기 먹는 하마’일까?
1년 만에 전력을 33분의 1로 줄인 비결, 그리고 ‘어제 그 사람’을 알아보는 AI의 기술
우리가 AI에게 질문 하나를 던질 때마다 어딘가에서 서버가 돌고 전기가 흐른다. 국제에너지기구(IEA)는 2025년 보고서 『Energy and AI』에서 전 세계 데이터센터가 2024년 약 415TWh, 세계 전력의 약 1.5%를 썼고, 2030년에는 약 945TWh로 두 배 넘게 늘어날 것이라 전망했다. 945TWh는 지금 일본이 한 해 동안 쓰는 전기보다 조금 많은 양이다. 같은 보고서는 AI 중심 데이터센터 한 곳이 가정 10만 가구만큼 전기를 쓴다고도 지적했다. 그렇다면 AI는 결국 전력망을 삼켜버릴 괴물이 되는 걸까. 흥미롭게도 답은 ‘꼭 그렇지는 않다’에 가깝다. 지금 이 순간에도 AI를 더 적은 전기로 움직이려는 노력이 소프트웨어와 반도체, 그리고 거리의 작은 카메라에 이르기까지 겹겹이 진행되고 있기 때문이다.
1년 만에 33분의 1, 소프트웨어가 만든 절약
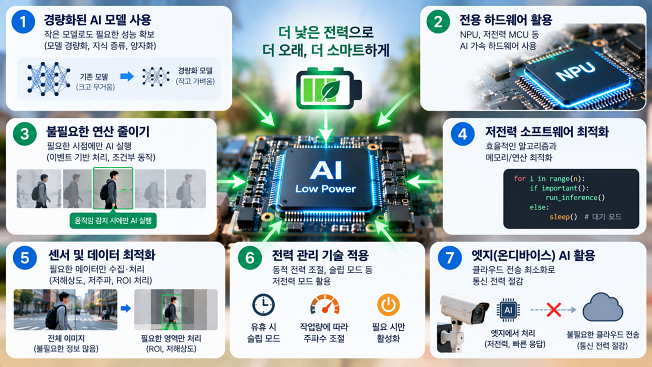
구글은 2025년 8월 공개한 논문에서 제미나이 앱의 중간값 텍스트 질문 하나가 0.24Wh의 전기를 쓴다고 밝혔다. TV를 9초 남짓 켜두는 정도다. 더 놀라운 것은 속도다. 2024년 5월부터 1년 사이 질문당 에너지가 33배 줄었고, 그중 23배는 모델 자체의 개선에서 나왔다. 대표적인 비결이 전문가 혼합(MoE) 구조다. 거대한 모델 전체를 깨우는 대신 질문에 필요한 일부 ‘전문가’만 불러내면 계산과 데이터 이동을 10~100배까지 줄일 수 있다. 숫자를 더 좁은 자료형으로 표현해 계산량과 메모리 이동을 줄이는 양자화, 큰 모델의 지식을 작은 모델에 옮겨 담는 지식 증류, 쓸모없는 연결을 잘라내는 가지치기도 같은 계열의 기술이다. 다만 이 수치는 기업이 스스로 측정한 결과이므로 외부의 검증이 계속 필요하다는 점도 함께 기억해 둘 만하다.
칩과 냉각, 그리고 ‘가까운 곳에서 계산하기’
하드웨어도 달라지고 있다. 구글은 최신 TPU ‘아이언우드’가 처음 공개한 TPU보다 에너지 효율이 30배 높다고 밝혔다. 범용 연산 대신 AI의 행렬 계산에 특화한 칩, 스마트폰과 노트북에 들어가는 NPU가 모두 같은 방향을 향한다. 냉각도 큰 몫을 차지한다. 딥마인드는 2016년 기계학습으로 데이터센터 냉각 장치를 제어해 냉각 에너지를 최대 40% 줄였다고 발표했다. 그러나 가장 근본적인 절약은 데이터를 멀리 보내지 않는 데 있다. 엣지 AI는 카메라나 기기 안에서 바로 계산하고 결과만 내보낸다. 영상 전체를 데이터센터로 실어 나르는 대신 ‘몇 명이 지나갔다’는 결론만 보내면 통신과 서버 양쪽의 전기를 함께 아낄 수 있다.
같은 장소, 다른 시간: AI는 ‘어제 그 사람’을 어떻게 알아볼까
엣지 AI가 활약하는 대표적 분야가 사람 재식별(Person Re-Identification, Re-ID)이다. 같은 건물 입구 카메라에 오전 9시와 오후 6시에 찍힌 두 사람이 동일인인지 판단하는 문제다. 얼굴을 정면으로 담기 어려운 CCTV 환경에서 AI는 사람의 모습을 수백 개의 숫자로 이루어진 ‘특징 벡터’로 바꾼다. 같은 사람의 벡터는 서로 가깝게, 다른 사람의 벡터는 멀어지도록 학습시키는 것이다. 이후의 비교는 영상을 다시 보는 일이 아니라 숫자 묶음 사이의 거리를 재는 일이므로 계산이 매우 가볍다.
실제 과정을 따라가 보면 이렇다. 먼저 작은 탐지 모델이 화면에서 사람이 있는 영역을 찾아 네모 상자로 잘라낸다. 다음으로 재식별 모델이 잘라낸 이미지를 특징 벡터로 바꾸고, 이것을 이전 시간대에 저장해 둔 벡터 목록과 하나씩 비교한다. 두 벡터가 가리키는 방향이 충분히 비슷하면, 즉 코사인 유사도가 정해 둔 기준을 넘으면 같은 사람으로 판단한다. 기준을 너무 낮추면 남을 같은 사람으로 착각하고, 너무 높이면 같은 사람을 놓친다. 그래서 현장에서는 여러 프레임의 벡터를 평균해 한 장면의 흔들림을 줄이고, 시간이 지나며 쌓인 기록으로 기준을 조금씩 다듬는다. 오전의 한 사람을 수천 장의 사진이 아니라 수백 개의 숫자로 기억한다는 것, 그것이 이 기술이 전기를 아끼는 핵심이다.
어려움은 시간이 흐를 때 생긴다. 조명과 그림자가 바뀌고, 무엇보다 옷이 바뀐다. 기존 Re-ID가 짧은 시간 안에는 옷이 같다는 전제에 기대 왔다면, 2020년 LTCC(장기 옷 변화) 데이터셋이 공개된 뒤 연구자들은 ‘옷을 갈아입은 같은 사람’을 찾는 장기 재식별에 매달리고 있다. 해법은 쉽게 바뀌는 단서 대신 잘 변하지 않는 단서에 주목하는 것이다. 체형과 신체 윤곽, 걸음걸이, 머리 부분의 특징이 대표적이다. 2025년 발표된 한 연구는 이미지 상단 20%만 잘라 머리 특징을 뽑고 스마트폰용 경량 신경망인 MobileNetV2를 결합해, 적은 계산량으로 옷 변화 문제를 다뤘다. ‘같은 장소’라는 조건도 힌트가 된다. 카메라와 배경이 고정되어 있으니 배경을 걷어내고 사람에게 집중하기 쉽고, 출입 시간대 같은 시공간 정보를 보조 단서로 쓸 수 있다.
전력 설계도 정교하다. 평소에는 아주 작은 움직임 감지기만 켜 두고, 사람이 나타날 때만 무거운 모델을 깨운다. 매개변수가 약 220만 개인 경량 모델 OSNet은 흔히 쓰이는 ResNet-50의 10분의 1도 안 되는 크기여서 엣지 장치에 올라가며, 실제로 이를 활용해 엣지 기기에서 Re-ID를 수행한 연구도 보고되었다. 물론 이 기술은 곧 사람을 추적하는 기술이기도 하다. 원본 영상 대신 특징 벡터만 남기고 정해진 기간 뒤 지우는 설계는 전기를 아끼는 동시에 사생활 위험을 줄이는 방향이지만, 벡터 역시 개인정보로 다뤄질 수 있으므로 개인정보 보호법이 정한 영상정보처리기기 운영 기준을 지키는 일이 먼저다.
결국 관건은 ‘크기’가 아니라 ‘영리함’이다
IEA는 2026년 후속 보고서에서 단순한 AI 질문 하나의 에너지는 크게 줄었지만, AI 에이전트처럼 훨씬 무거운 사용 방식이 빠르게 늘고 있다고 경고했다. 효율이 좋아질수록 사용량이 더 늘어나는 역설이다. 그러니 AI의 전력 문제는 ‘얼마나 많이 쓰느냐’만큼 ‘얼마나 영리하게 아끼느냐’의 문제다. 필요한 전문가만 깨우는 모델, 계산 전용 칩, 현장에서 끝내는 엣지 AI, 그리고 옷이 바뀌어도 같은 사람을 숫자 몇백 개로 알아보는 Re-ID까지. AI가 똑똑해진다는 말은 이제, 더 적은 전기로 더 많은 것을 알아본다는 뜻이기도 하다.