피지컬 AI가 정량적 값에는 강하고 정성적 값에는 약한 진짜 이유
로봇은 0.02mm는 재면서 왜 ‘같은 사람’은 못 알아볼까?
피지컬 AI가 정량적 값에는 강하고 정성적 값에는 약한 진짜 이유
자동차 공장의 로봇팔은 수백 번을 반복해도 부품을 거의 같은 자리에 끼워 넣는다. 자율주행차는 앞차와의 거리를 센티미터 단위로 계산하고, 물류 로봇은 선반의 높이와 상자의 무게를 정확히 읽어 낸다. 그런데 이 똑똑한 기계들에게 아침 9시에 출입문을 지나간 사람과 저녁 7시에 옷을 갈아입고 같은 문을 지나간 사람이 동일인인지 물으면, 대답은 갑자기 불안해진다. 숫자는 그렇게 잘 다루는 피지컬 AI가 왜 ‘같다’, ‘위험해 보인다’, ‘조심스럽게’ 같은 말 앞에서는 머뭇거릴까.
숫자는 센서가 주지만, 의미는 아무도 주지 않는다
피지컬 AI가 다루는 값은 크게 두 종류다. 거리, 속도, 온도, 토크, 좌표처럼 센서가 곧바로 숫자로 건네주는 정량적 값이 하나이고, ‘동일인이다’, ‘저 컵은 깨지기 쉬워 보인다’, ‘저 사람은 길을 비켜 줄 것 같다’처럼 여러 단서를 엮어 해석해야 하는 정성적 값이 다른 하나다. 정량적 값은 정답이 하나로 정해져 있고 오차를 잴 수 있다. 라이다가 5.2미터라고 하면 그것은 5.2미터다. 반면 정성적 값은 세상에 측정값으로 존재하지 않는다. 그것은 대상과 맥락, 시간과 관계 사이에 흩어져 있다. 기계가 약한 이유는 계산 능력이 모자라서가 아니라, 계산할 대상 자체가 숫자의 형태로 주어지지 않기 때문이다.
이 현상은 오래전부터 알려져 있었다. 로봇공학자 한스 모라벡은 1988년 『마인드 칠드런』에서 체스나 수학처럼 인간에게 어려운 일은 컴퓨터에게 쉽고, 걸음마 수준의 지각과 운동은 오히려 가장 어렵다고 지적했다. 이른바 ‘모라벡의 역설’이다. 철학자 마이클 폴라니는 1966년 『암묵적 차원』에서 “우리는 말할 수 있는 것보다 더 많이 안다”고 썼다. 우리는 친구의 얼굴을 수천 명 속에서 알아보지만, 그 방법을 규칙으로 적어 내지는 못한다. MIT의 경제학자 데이비드 오터는 2014년 이 개념을 ‘폴라니의 역설’로 정리하며, 규칙으로 명시할 수 없는 일일수록 자동화가 어렵다고 분석했다. 규칙으로 적을 수 없다는 것은 곧 정답 라벨을 붙이기 어렵다는 뜻이고, 라벨이 없으면 기계는 학습할 목표를 잃는다.
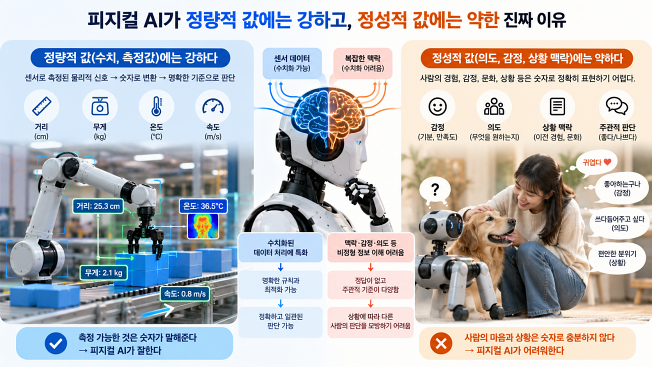
인지과학자 스테반 하나드가 1990년 제기한 ‘기호 접지 문제’도 같은 지점을 가리킨다. ‘5.2미터’라는 기호는 레이저의 왕복 시간이라는 물리 현상에 단단히 붙어 있다. 그러나 ‘조심스럽게’라는 말은 무엇에 붙어 있는가. 힘의 크기인가, 속도인가, 물건의 재질인가, 옆에 선 사람의 표정인가. 접지할 곳이 여러 곳에 흩어져 있으니 기계는 의미를 붙잡지 못한다.
최근 데이터도 이를 뒷받침한다. 2025년 ICLR에 발표된 PhysBench는 75개의 시각·언어 모델에게 물체의 성질, 장면의 관계, 물리적 변화를 묻는 1만여 개의 문제를 풀게 했다. 가장 잘한 GPT-4o의 정답률은 49.49%였고, 사람은 95.87%였다. 연구진은 원인으로 학습 데이터에 물리적 지식이 부족하고 모델 안에 물리적 사전 지식이 내장돼 있지 않다는 점을 꼽았다. 말은 유창하게 하지만, 그 말이 가리키는 세계의 질감은 아직 모른다는 이야기다.
같은 장소, 다른 시간의 그 사람을 어떻게 알아볼까
정성적 판단의 어려움이 가장 선명하게 드러나는 곳이 ‘사람 재식별(Person Re-identification)’이다. 여러 카메라나 여러 시간대에 찍힌 사람이 같은 인물인지 가려내는 기술이다. 옷이 바뀌지 않는 표준 데이터셋 Market-1501에서는 2026년 발표된 T3FRNet이 1순위 정답률(Rank-1) 96.2%를 기록했다. 거의 완벽에 가깝다. 그런데 사무실 건물 세 개 층에 설치된 12대의 CCTV로 두 달 동안 하루 24시간 촬영해, 152명이 478벌의 옷을 바꿔 입은 모습을 담은 LTCC 데이터셋에서 옷이 바뀐 경우만 따로 평가하면 같은 모델의 정답률은 45.6%로 떨어진다. 같은 건물, 다른 시간, 다른 옷이라는 조건 하나에 절반 넘게 틀리는 것이다.
이유는 단순하다. 모델은 ‘같은 사람’이라는 정성적 개념을 스스로 이해하는 대신, 옷의 색과 무늬라는 정량적 픽셀 통계로 슬그머니 바꿔 풀고 있었다. 옷이 같을 때는 그 지름길이 통했지만, 옷이 바뀌자 지름길이 끊겼다. 그래서 연구자들은 정성적 판단을 여러 개의 믿을 만한 정량 단서로 다시 쪼개는 방향으로 나아가고 있다. 첫째는 옷에 흔들리지 않는 특징이다. 체형과 어깨선, 머리와 얼굴의 윤곽, 걸음걸이의 리듬처럼 하루 사이에 잘 변하지 않는 신체 정보를 뽑아 옷 정보를 의도적으로 지운다.
둘째는 시간과 공간의 정보다. 사람은 순간 이동을 하지 않으므로, 어느 카메라에서 어느 카메라로 몇 분 만에 이동할 수 있는지를 확률로 계산하면 후보가 크게 줄어든다. 시각 특징에 이 시공간 정보를 결합한 st-ReID 연구는 Market-1501에서 정답률을 91.2%에서 98.1%로 끌어올렸다. 셋째는 말로 된 속성이다. 옷을 갈아입어도 변하지 않는 성별, 머리 길이, 안경 착용 같은 속성 설명을 시각 정보와 묶어 학습시키는 방법이 제안되고 있다.
‘같은 장소’라는 조건은 오히려 기계에게 유리한 재료가 된다. 카메라 각도와 배경이 고정되어 있으니 변하는 것은 사람과 빛뿐이다. 배경을 지우고, 시간대별 조명 차이를 보정하고, 그 자리를 지나는 사람들의 평소 동선과 머무는 시간을 누적하면 ‘이 시간에 이 문을 이 걸음으로 지나는 사람’이라는 통계적 윤곽이 생긴다. 사람이 경비실 창 너머로 “아, 아까 그분이네” 하고 알아보는 과정도 사실은 얼굴 하나가 아니라 체격, 걸음, 가방, 시간대 같은 단서를 순식간에 합산하는 일에 가깝다. 다만 이런 기술은 개인을 추적하는 힘과 맞닿아 있어, 어디까지 허용할지는 기술이 아니라 사회가 정해야 할 몫이다.
정성을 정량으로 번역하는 기계, 번역되지 않는 것을 맡는 사람
결국 피지컬 AI가 정성적 값을 다루지 못하는 까닭은 지능이 모자라서가 아니라, 정성적 값이 세계에 하나의 측정값으로 놓여 있지 않기 때문이다. 그것은 관계와 맥락과 시간 속에 흩어져 있고, 인간조차 그 규칙을 말로 다 적지 못한다. 그래서 지금의 해법은 두 갈래다. 정성을 믿을 만한 정량 단서의 다발로 번역하는 기술을 키우는 것, 그리고 끝내 번역되지 않는 판단은 사람의 몫으로 남겨 두는 설계를 하는 것이다. 로봇이 0.02밀리미터를 재는 동안, ‘그 사람이 맞는가’를 묻는 일은 여전히 우리에게 남아 있다. 그 질문을 기계에 어떻게, 그리고 어디까지 넘겨줄지가 피지컬 AI 시대의 진짜 과제다.