정량적 값과 정성적 값의 차이, 숫자가 놓치는 것과 느낌이 틀리는 것
정량적 값과 정성적 값의 차이, 숫자가 놓치는 것과 느낌이 틀리는 것
1999년 영국 글래스고 대학의 마이크 버턴 연구팀은 화질이 낮은 보안 카메라 영상을 여러 사람에게 보여 주고, 화면 속 인물을 알아보게 했다. 결과는 극적으로 갈렸다. 영상 속 인물을 평소 알고 지내던 동료들은 흐릿한 화면에서도 거의 틀리지 않았다. 반면 처음 보는 사람들은 형편없는 성적을 냈고, 법의학적 신원 확인 경험이 있는 경찰관들도 마찬가지였다. 키도, 옷 색깔도, 찍힌 시각도 모두에게 똑같이 주어졌는데 무엇이 이 차이를 만들었을까. 이 질문은 우리가 매일 쓰면서도 잘 구분하지 못하는 두 가지 값, 정량적 값과 정성적 값의 차이로 곧장 이어진다.
정량적 값과 정성적 값, 무엇이 다른가
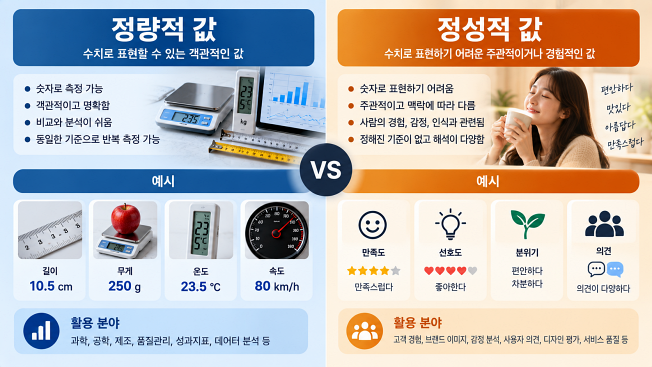
정량적 값은 수로 재고 단위로 표현하며 크기를 비교할 수 있는 값이다. 키 172센티미터, 출입 시각 오후 2시 5분, 체류 시간 12분이 그렇다. 정성적 값은 대상의 성질이나 범주, 의미를 말로 기술하는 값이다. ‘단정한 인상’, ‘익숙한 걸음걸이’, ‘긴장한 표정’이 여기에 속한다. 이 구분의 이론적 토대를 놓은 사람은 하버드의 심리학자 스탠리 스미스 스티븐스다. 그는 1946년 『사이언스』에 실린 논문에서 측정을 명목·서열·등간·비율의 네 척도로 나누고, 척도마다 허용되는 계산이 다르다고 밝혔다. 운동선수의 등번호는 숫자로 적혀 있지만 이름표일 뿐이어서 평균을 내면 아무 의미가 없다. 숫자의 모양을 하고 있다고 모두 정량적 값은 아니라는 뜻이다. 반대로 몸무게 60킬로그램과 30킬로그램은 두 배라고 말할 수 있다. 결국 정량과 정성을 가르는 기준은 표기 방식이 아니라, 그 값으로 더하고 빼고 나눌 수 있느냐다.
두 값은 강점과 약점이 정확히 엇갈린다. 정량적 값은 누가 재도 같은 결과가 나오고, 비교와 검증이 쉽다. 그러나 숫자로 옮기는 순간 맥락이 잘려 나간다. 정성적 값은 의미와 맥락을 풍부하게 담지만, 보는 사람에 따라 달라지고 재현하기 어렵다. 사회학자 윌리엄 브루스 캐머런은 1963년 “셀 수 있는 모든 것이 중요한 것은 아니며, 중요한 모든 것을 셀 수 있는 것도 아니다”라고 썼다. 흔히 아인슈타인의 말로 잘못 알려진 이 문장은 숫자만 믿는 태도의 위험을 경고한다. 여론조사 전문가 대니얼 얀켈로비치는 1972년 이를 ‘맥나마라 오류’라고 불렀다. 베트남 전쟁 당시 미 국방부가 적군 사망자 수처럼 측정하기 쉬운 지표만으로 전황을 판단하다 실패한 데서 나온 이름이다.
그렇다고 정성적 판단이 늘 옳은 것도 아니다. 비키 브루스 연구팀이 1999년 진행한 실험에서, 참가자들은 시간 제한 없이 좋은 조건의 사진을 보며 열 장 가운데 같은 인물을 고르는 과제를 풀었지만 정확도는 70% 정도에 머물렀다. 처음 보는 얼굴 앞에서 ‘닮았다’는 느낌은 생각보다 자주 우리를 속인다.
같은 장소, 다른 시간대에 나타난 사람을 어떻게 알아볼까
같은 출입문을 아침과 저녁에 지나간 두 사람이 동일인인지 판단하는 일은, 정량과 정성의 차이가 가장 선명하게 드러나는 시험대다. 핵심 난관은 ‘한 사람 안의 변화’다. 2011년 롭 젠킨스와 버턴 연구팀은 두 사람의 사진 40장을 섞어 참가자들에게 같은 사람끼리 묶어 보라고 했다. 이 인물들을 모르는 참가자들은 평균 7명이 넘는 서로 다른 사람으로 나눴지만, 이들을 잘 아는 참가자들은 거의 정확히 두 사람으로 묶었다. 조명과 각도, 표정과 시간이 바뀌면 같은 사람도 전혀 다른 사람처럼 보인다. 친숙함이란 한 사람의 여러 모습을 경험하며 쌓인 정성적 표상이고, 버턴의 CCTV 실험에서 동료들이 흐린 화면을 이겨 낸 비결도 여기에 있었다. 흥미롭게도 같은 실험에서 몸이나 걸음걸이를 가렸을 때는 성적이 조금만 떨어졌고, 연구진은 사람들이 결국 얼굴로 알아보았다고 결론지었다.
기계는 이 친숙함을 갖고 있지 않다. 그래서 정성적 판단을 정량적 단서로 쪼개서 푼다. 여러 카메라와 시간대의 인물을 대조하는 ‘사람 재식별’ 기술은 옷이 바뀌지 않는 Market-1501 데이터셋에서 최근 96.2%의 1순위 정답률을 보였다. 하지만 사무실 건물에서 두 달간 촬영한 LTCC 데이터셋에서 옷을 갈아입은 경우만 평가하면 45.6%로 떨어진다. 모델이 ‘같은 사람’이라는 의미 대신 옷 색깔이라는 숫자를 붙잡고 있었기 때문이다. 반대로 카메라 위치와 시간 간격이라는 정량적 정보를 결합한 연구는 정답률을 91.2%에서 98.1%로 끌어올렸다.
그렇다면 실전에서는 어떻게 해야 할까. 먼저 정량적 단서를 모은다. 같은 장소라면 배경과 카메라 각도가 고정되어 있으므로 문틀 높이를 기준으로 키를 추정할 수 있고, 출입 시각과 체류 시간, 이동 경로와 보행 속도를 기록해 비교할 수 있다. 다음으로 정성적 단서를 더한다. 어깨를 쓰는 버릇, 가방을 드는 손, 문을 여는 방식처럼 옷을 바꿔도 남는 습관이다. 마지막으로 두 종류의 단서가 서로 맞아떨어지는지 교차 확인한다. 저녁 조명이 색과 윤곽을 바꿀 수 있다는 점, 그리고 이런 추적이 개인정보와 맞닿아 있다는 점도 함께 기억해야 한다.
숫자는 ‘얼마나’를, 말은 ‘무엇’을 말한다
정량적 값과 정성적 값은 서로를 대체하는 관계가 아니라 서로를 번역하는 관계다. 정량은 ‘얼마나’를 정확하게 말하고, 정성은 그것이 ‘무엇’인지를 말한다. 숫자만 믿으면 맥나마라의 실수를 반복하고, 느낌만 믿으면 낯선 얼굴 앞에서 열에 셋은 틀린다. 흐린 CCTV 속 친구를 단번에 알아보는 힘은 수많은 순간의 숫자를 하나의 의미로 묶어 온 경험에서 나온다. 좋은 판단이란 그 두 언어를 오가며, 숫자가 놓친 것은 말로 붙잡고 말이 흔들리는 곳은 숫자로 붙드는 일이다.